产品概要说明
ℹ️
数据隐私声明
Lixel CyberColor Studio (Linux Server) 以数据隐私为核心原则,确保敏感信息始终保持在客户的私有环境内。该软件仅在客户控制的Docker环境中运行,所有与业务系统的交互都仅限于读取操作,经客户授权,确保没有写入权限或数据修改。 关键的数据隐私措施包括:
- 隔离处理:LCC软件完全在客户的私有基础设施内处理数据,设计上不需要或执行任何数据传输到外部服务器或第三方服务。
- 授权驱动的访问:所有由业务系统发起的API调用都通过客户提供的访问密钥进行身份验证,确保仅发生授权的交互。
- 不读取外部数据:该软件严格只操作指定工作目录内的数据,不会访问、读取或传输客户私有服务器或任何外部系统的数据。
- 客户控制:所有输入和输出目录由客户定义,赋予客户对数据流的完全控制,并确保符合内部数据治理政策。
产品介绍
LCC Studio (Linux Server) 是一款高效、可扩展的容器化产品,该软件支持单地图重建、地图融合、空地融合多种重建模式,并具备集群计算能力,以高效处理大规模3D重建任务。基于Docker技术,LCC重建软件能够与业务系统无缝集成,支持灵活部署,并充分利用多GPU并行计算,显著提升重建性能。此外,该软件允许开发者导出数据,便于进行二次开发和生态应用扩展。
功能概况
说明:单地图重建、地图融合、空地融合、开发者数据、集群模式均为高级功能(增值服务),产品具体包含的功能视用户需求来定,详情可联系其域创新销售。
- 多模式重建:支持 单地图重建、地图融合、空地融合 重建,在采集手法规范的情况下,本版本产品最大推荐500min以内的地面扫描时长、15000张以内无人机图片进行3DGS重建,适用于多种场景建模需求。
- 高效计算:仅支持对地图融合、空地融合的多GPU并行加速,显著提升重建性能,满足大规模数据处理需求。
- 数据开放性:支持 开发者数据导出,便于二次开发及生态应用扩展。
- 系统兼容性:提供 HTTP API,便于与其他业务系统高效集成,实现自动化处理与应用扩展。
- 算法升级:本版本所采用的算法对内存占用和细节效果进行了优化。
- 授权方式:本版本支持在线授权、离线硬授权与离线软授权
工作流
说明:当软件启动时,仅从XGRIDS服务器获取认证信息。在此过程中,虽然与服务器有交互,但不涉及工作数据。此过程仅限于授权验证,确保安全访问系统,而不会访问、传输或处理客户的私有数据。
产品架构
分布式计算
框架
设施
业务集成
准备数据
- 按文档要求,将输入数据整理到指定的工作目录。
启动多图融合重建
- 使用提供的HTTP API启动重建任务
监控进度
- 轮询API获取实时状态更新,直到任务完成
配置要求
硬件说明
LCC重建任务的性能表现主要受CUDA Core和FP32 TFLOPS(每秒浮点运算)影响。与显卡的NVLink、Tensor Core(AI算力)、FP64等特性以及显存(≥32GB)关系较小。因此,部分高端AI卡(如A100、H100等)的性能表现,反而可能不如某些具有更高CUDA Core和FP32算力的低端型号(如A10、L40等)。
LCC重建任务性能分布:
LCC重建流程大致可分为两部分:
- GPU密集型算法:占比约一半,这部分任务受GPU性能的影响较大,尤其是CUDA Core和FP32算力。
- CPU密集型算法:占比约一半,GPU的性能对这部分计算时长的影响较小。
因此,GPU性能仅对GPU密集型部分的重建时长产生显著影响。而对于CPU密集型部分,CPU的性能起到更关键作用。
显卡推荐
在选择显卡时,建议根据任务需求和预算选择适合的型号。以下是我们推荐的显卡列表,按性能排序:
- L40:在重建任务中,L40凭借更强的 Core和FP32 能力,提供了最佳的性能表现。
- RTX 4090:作为一款面向消费者的高端显卡,RTX 4090提供了出色的CUDA Core性能和高效的FP32计算,适合大多数LCC重建任务。
- RTX 4090 D:国内特供版。
- L20:相比于L40,L20仍然保持了较高的CUDA Core和FP32算力,适合性能需求较高但预算相对有限的用户。
- RTX 3090:虽然性能略低于RTX 4090,但在许多重建任务中依然提供了非常强劲的性能,适合性价比要求较高的用户。
- A10:适用于预算较为有限的用户,虽然性能低于上述几款显卡,但依然能够满足基础的LCC重建任务需求。
注意:
- 显存:显存大小(≥24GB)对LCC重建任务的影响相对较小,除非处理极大规模的场景,否则在推荐的GPU数量区间内,增加更多显存或显存超过32GB的显卡对提升任务效率的作用有限。
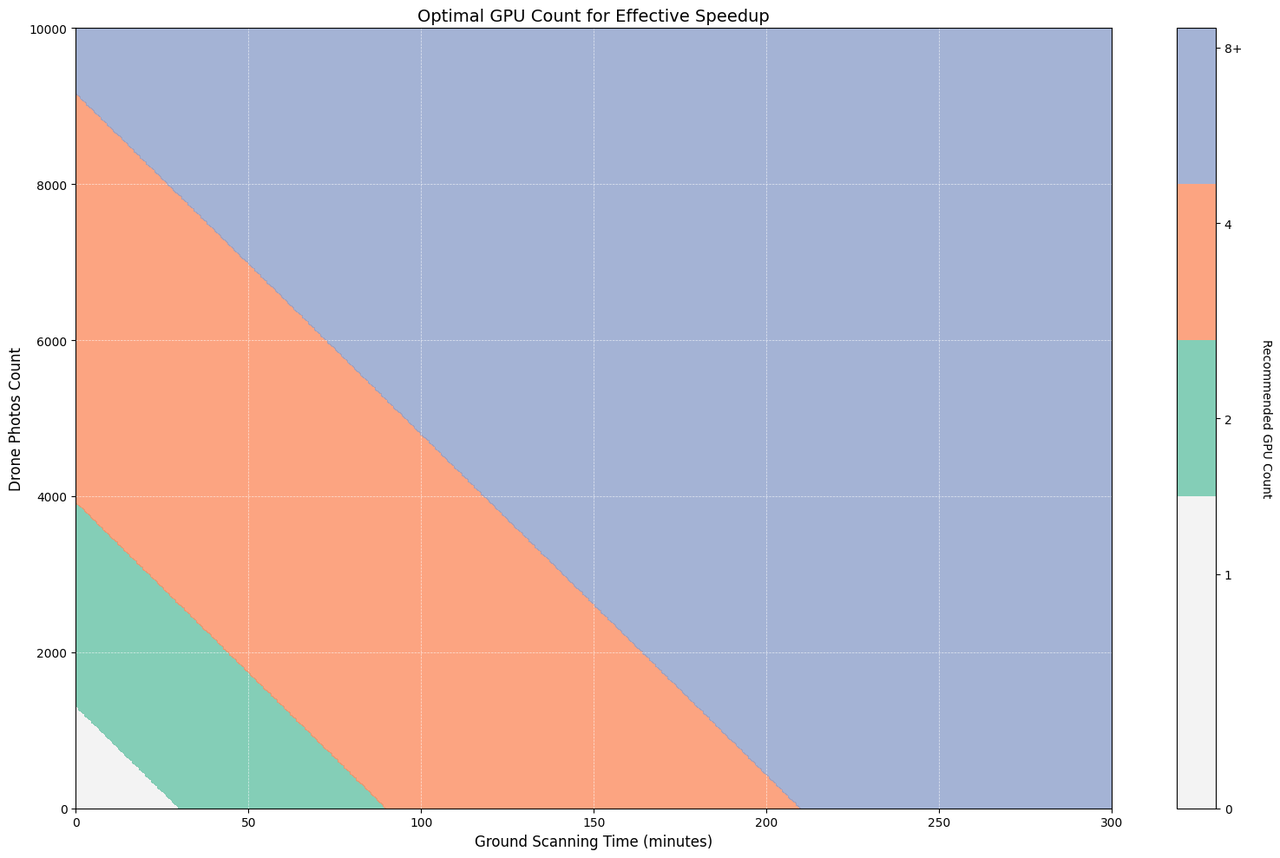
- 多卡配置:当重建较大场景时,多GPU可以产生加速效果。场景大小(扫描时长+无人机图片数)和最多能使用的GPU卡数的关系如表所示。
下表为GPU性能参照表,其中红色带*的型号是实际对比过的型号,有比较准确的相对算力估计;其余的型号根据相似架构估计得到。
| 型号 | CUDA Core | FP32 TFLOPS | 相对算力 |
|---|---|---|---|
| RTX 5090/ RTX 5090 D | 21760 | 104.8 | 1.27~1.33 |
| RTX 6000 Ada | 18176 | 91.06 | 1.1~1.11 |
| L40 | 18176 | 90.52 | 1.1~1.11 |
| RTX 4090* | 16384* | 82.58* | 1.00* |
| RTX 4090 D* | 14592* | 73.54* | 0.89* |
| H100 PCIe 96G | 16896 | 62.08 | 0.75~1.03 |
| H800 PCIe 80G | 14592 | 51.22 | 0.62~0.89 |
| L20 | 11776 | 59.35 | 0.72~0.72 |
| RTX A6000 | 10752 | 38.71 | 0.64~0.67 |
| RTX 3090* | 10496* | 35.58* | 0.62* |
| A10 | 9216 | 31.24 | 0.54~0.54 |
| L4 | 7424 | 30.29 | 0.37~0.45 |
| A100/A800 | 6912 | 19.49 | 0.34~0.41 |
| RTX 3060* | 3584* | 12.74* | 0.22* |
| RTX 2060 Laptop* | 1920* | 4.608* |
多卡配置
- 当重建较大场景时,多GPU可以产生加速效果。场景大小(地面扫描时长+无人机图片数)和最多能使用的GPU卡数的关系如表所示。