
安装部署说明书
2 服务器环境配置(Ubuntu20.04以上 ~ 24.04)
1. Nvidia显卡驱动安装
#下载驱动程序
wget https://download.nvidia.com/XFree86/Linux-x86_64/550.120/NVIDIA-Linux-x86_64-550.120.run

All versions :https://download.nvidia.com/XFree86/Linux-x86_64/

chmod +x NVIDIA-Linux-x86_64-550.120.run

# 安装需要gcc编译环境,如果没有则需要安装build-essential
sudo apt-get install build-essential -y

#执行安装
sudo ./NVIDIA-Linux-x86_64-550.120.run
注:最低版本依赖
| 驱动 | 版本 | 支持架构 | 操作系统 |
|---|---|---|---|
| NVIDIA Linux Driver | 545.23.08 | x86_64, arm64-sbsa, POWER | Linux |
| NVIDIA Windows Driver | 546.12 | x86_64 (Windows) | Windows, WSL |
2. Docker以及Nvidia显卡支持安装
# 服务器安装docker
sudo apt update
sudo apt install docker.io
# 安装nvidia容器化支持
# 方式1
#按照最新的官方安装文档执行:
https://docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html
# 方式2
# 如果中国大陆地区,在线安装方式可能由于网络问题等无法成功
# 从 镜像站 https://mirror.cs.uchicago.edu/nvidia-docker/ 下载libnvidia-container1, libnvidia-container-tools, nvidia-container-runtime, nvidia-docker2的.deb文件
# 我们提供了一个所需deb包的临时下载地址:https://cdn-bukbb1.xgrids.cloud/static/nvidia/docker-nvidia-support-ubuntu.zip
# 得到所有deb文件后执行安装:
sudo dpkg -i ./*.deb # 安装所有下载的deb包
#重启docker
sudo systemctl restart docker
# 运行测试容器检测GPU是否正常:
sudo docker run --rm --gpus all nvidia/cuda:11.6.2-base nvidia-smi
#docker: Error response from daemon: Get "https://registry-1.docker.io/v2/": net/http: request canceled while waiting for connection (Client.Timeout exceeded while awaiting headers).
"registry-mirrors": ["https://docker.anyhub.us.kg","https://dockerhub.jobcher.com","https://dockerhub.icu"]
sudo systemctl daemon-reload
sudo systemctl restart docker
3. 特殊配置(必须!)
1)修改Docker的cgroupdriver为cgroupfs
NVIDIA显卡在容器中使用有一个已知问题:容器在运行过程中会突然丢失显卡 (Containers losing access to GPUs with error: "Failed to initialize NVML: Unknown Error")
目前该ISSUE的官方状态是尚未解决。参考:
https://github.com/NVIDIA/nvidia-docker/issues/1730
https://github.com/NVIDIA/nvidia-container-toolkit/issues/48
确认服务器是否受此ISSUE影响的方式:
 $ docker info
 ...
 Cgroup Driver: systemd     # 如果看到Cgroup Driver = systemd,则可能发生此问题
 Cgroup Version: 1
英伟达官方提供的解决办法:
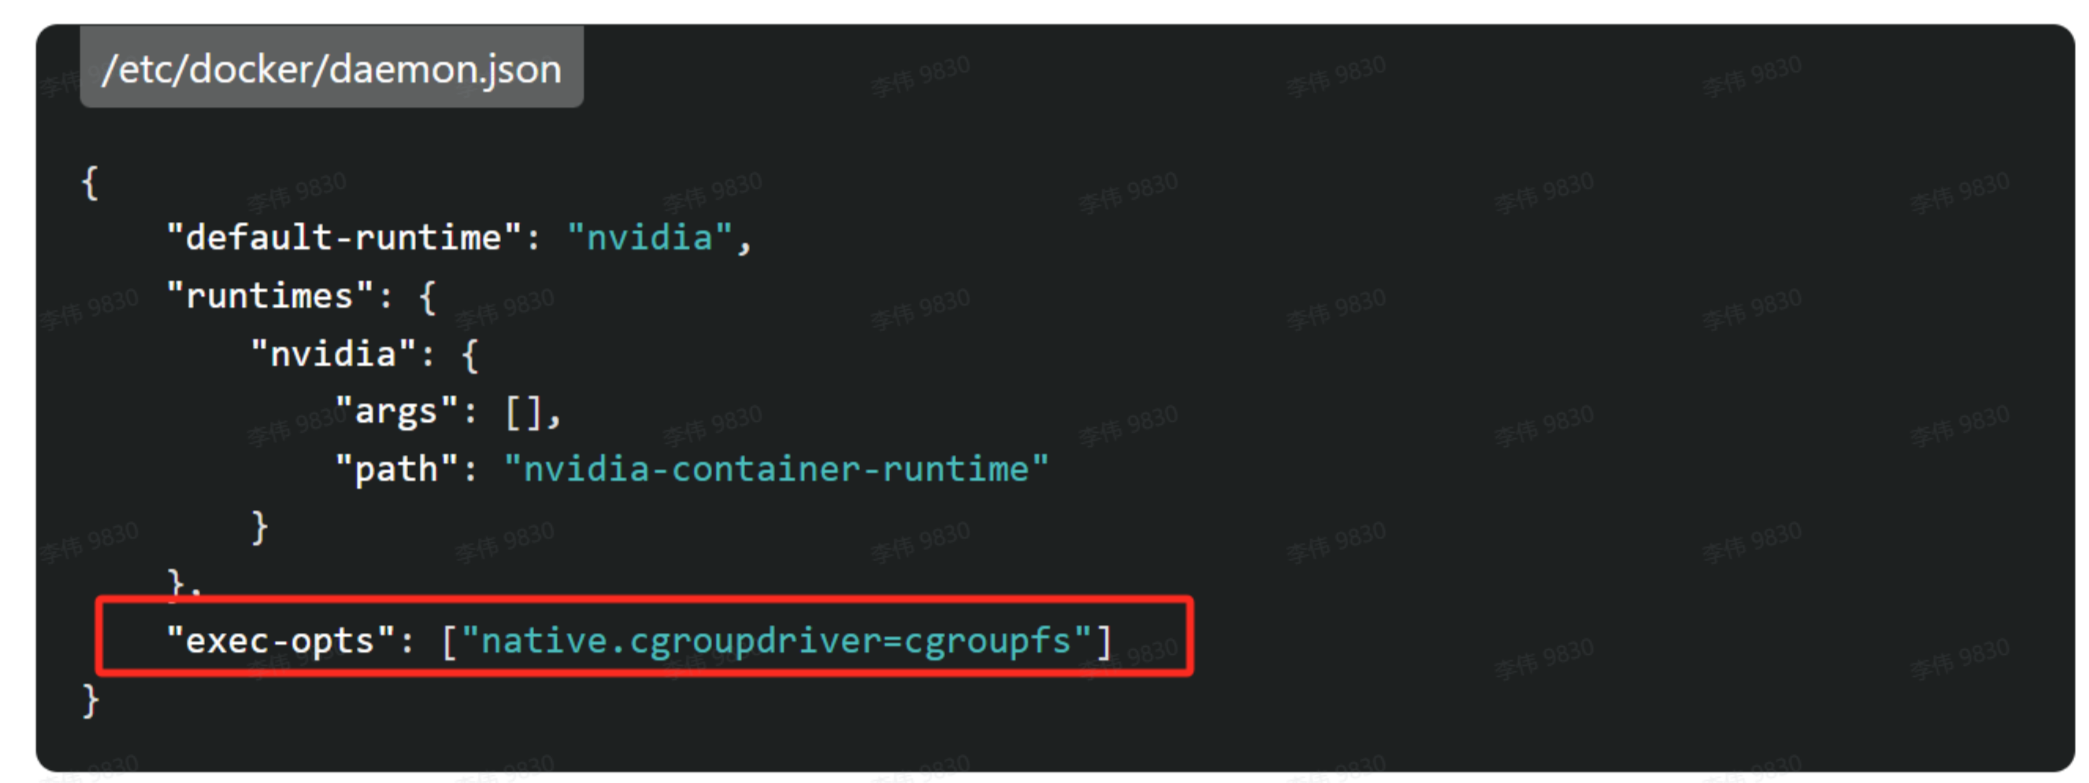
手工修改/etc/docker/daemon.json 添加参数 "exec-opts": ["native.cgroupdriver=cgroupfs"]然后重启Docker。
(Set the parameter "exec-opts": ["native.cgroupdriver=cgroupfs"] in the /etc/docker/daemon.json file and restart docker.)
2)开启NVIDIA显卡驱动的持久模式(常驻模式)
开启持久模式:
sudo nvidia-smi -pm 1
未开启持久模式的影响:
- GPU 每次被访问时都会初始化,增加延迟
- 表现: 运行
nvidia-smi、CUDA 程序或加载模型时,GPU 会经历一次驱动初始化。nvidia-smi命令执行速度较慢。 - 影响: 启动时间延长、命令反应慢,甚至应用层出现卡顿。
- 功耗控制频繁切换,性能不稳定
- GPU 在空闲时会自动进入低功耗状态(如关闭显存、关闭时钟),再激活时要“唤醒”GPU。
- 导致高频使用时出现“性能抖动”。
- 在服务器或集群中降低多任务响应效率
- 在深度学习训练、推理、图形渲染等高频使用 GPU 的场景中,频繁初始化会增加系统负担,尤其在多用户/多进程使用场景下。
- 某些容器或守护进程可能反复触发 GPU 初始化
- 例如 Docker 中配置不当时,容器每次启动可能触发一次 GPU 初始化。
开启后:
- GPU 驱动始终保持加载状态,无需每次访问都重新初始化。
- 启动时间更短,如 CUDA 程序、深度学习框架加载速度更快。
- 更稳定的运行性能,尤其是在集群或自动化任务中。
在服务器、深度学习、渲染等重度 GPU 使用场景中: 建议启用。
只有在普通桌面使用或电源敏感环境(如笔记本)使用场景下,可根据情况关闭,以节省功耗。
4. 其他已知问题
1) 高端显卡+多卡服务器,容器内GPU无法正常使用问题
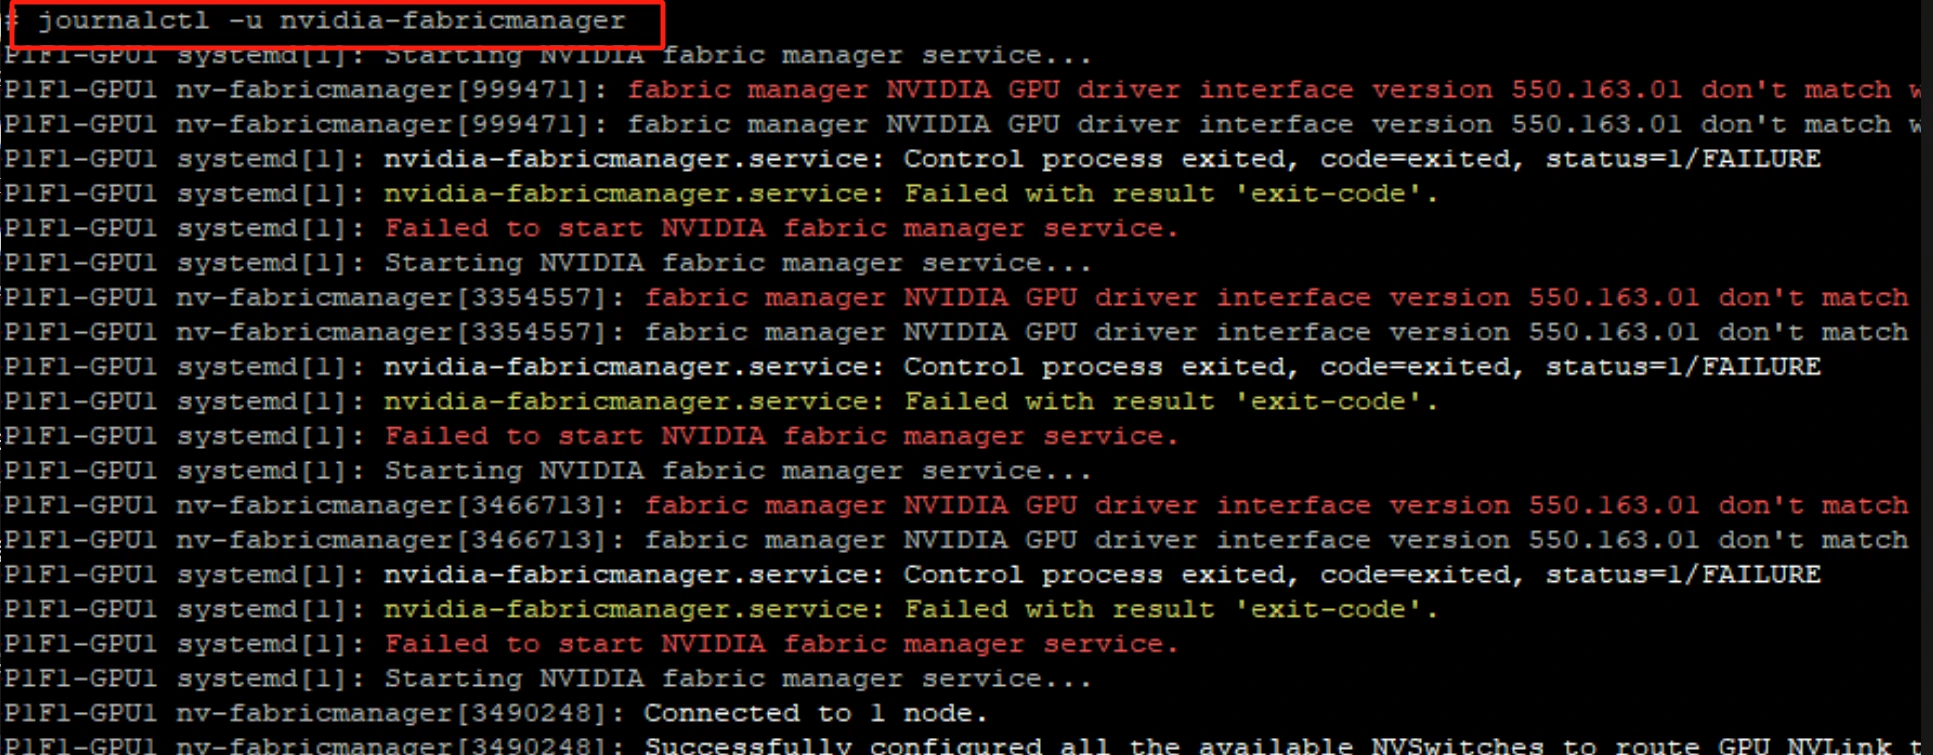
在安装有多个高端NVIDIA显卡(H100/V100/A100/A30等)服务器上,除了安装对应的驱动,有时还要安装与驱动版本完全一致的 nvidia-fabricmanager 服务,才能够正常进行重建。
失败的现象是,在容器内执行nvidia-smi和nvcc命令,均输出正常;但是实际重建失败;重建报错如下,且多次重试均失败:
- 错误代码:
0x34040070 - 错误日志:
Unspecified GPU Error: Update GPU drivers to the latest stable version and restart the computer.
查看服务器错误日志,有可能发现有报错提示nvidia-fabricmananger的版本不一致:
解决方式
需按照NVIDIA的官方文档,安装与当前驱动版本完全一致的nvidia-fabricmananger,并从操作系统层面,禁止其自动更新。建议由服务器的技术运维人员处理。