產品概要說明
ℹ️
數據隱私聲明
Lixel CyberColor Studio (Linux Server) 以數據隱私為核心原則,確保敏感信息始終保持在客戶的私有環境內。該軟件僅在客戶控制的Docker環境中運行,所有與業務系統的交互都僅限於讀取操作,經客戶授權,確保沒有寫入權限或數據修改。 關鍵的數據隱私措施包括:
- 隔離處理:LCC軟件完全在客戶的私有基礎設施內處理數據,設計上不需要或執行任何數據傳輸到外部服務器或第三方服務。
- 授權驅動的訪問:所有由業務系統發起的API調用都通過客戶提供的訪問密鑰進行身份驗證,確保僅發生授權的交互。
- 不讀取外部數據:該軟件嚴格只操作指定工作目錄內的數據,不會訪問、讀取或傳輸客戶私有服務器或任何外部系統的數據。
- 客戶控制:所有輸入和輸出目錄由客戶定義,賦予客戶對數據流的完全控制,並確保符合內部數據治理政策。
產品介紹
LCC Studio (Linux Server) 是一款高效、可擴展的容器化產品,該軟件支持單地圖重建、地圖融合、空地融合多種重建模式,並具備集群計算能力,以高效處理大規模3D重建任務。基於Docker技術,LCC重建軟件能夠與業務系統無縫集成,支持靈活部署,並充分利用多GPU並行計算,顯著提升重建性能。此外,該軟件允許開發者導出數據,便於進行二次開發和生態應用擴展。
功能概況
說明:單地圖重建、地圖融合、空地融合、開發者數據、集群模式均為高級功能(增值服務),產品具體包含的功能視用戶需求來定,詳情可聯繫其域創新銷售。
- 多模式重建:支持 單地圖重建、地圖融合、空地融合 重建,在採集手法規範的情況下,本版本產品最大推薦500min以內的地面掃描時長、15000張以內無人機圖片進行3DGS重建,適用於多種場景建模需求。
- 高效計算:僅支持對地圖融合、空地融合的多GPU並行加速,顯著提升重建性能,滿足大規模數據處理需求。
- 數據開放性:支持 開發者數據導出,便於二次開發及生態應用擴展。
- 系統兼容性:提供 HTTP API,便於與其他業務系統高效集成,實現自動化處理與應用擴展。
- 算法升級:本版本所採用的算法對內存佔用和細節效果進行了優化。
- 授權方式:本版本支持在線授權、離線硬授權與離線軟授權
工作流
說明:當軟件啟動時,僅從XGRIDS服務器獲取認證信息。在此過程中,雖然與服務器有交互,但不涉及工作數據。此過程僅限於授權驗證,確保安全訪問系統,而不會訪問、傳輸或處理客戶的私有數據。
產品架構
分佈式計算
框架
設施
業務集成
準備數據
- 按文檔要求,將輸入數據整理到指定的工作目錄。
啟動多圖融合重建
- 使用提供的HTTP API啟動重建任務
監控進度
- 輪詢API獲取實時狀態更新,直到任務完成
配置要求
硬件說明
LCC重建任務的性能表現主要受CUDA Core和FP32 TFLOPS(每秒浮點運算)影響。與顯卡的NVLink、Tensor Core(AI算力)、FP64等特性以及顯存(≥32GB)關係較小。因此,部分高端AI卡(如A100、H100等)的性能表現,反而可能不如某些具有更高CUDA Core和FP32算力的低端型號(如A10、L40等)。
LCC重建任務性能分佈:
LCC重建流程大致可分為兩部分:
- GPU密集型算法:佔比約一半,這部分任務受GPU性能的影響較大,尤其是CUDA Core和FP32算力。
- CPU密集型算法:佔比約一半,GPU的性能對這部分計算時長的影響較小。
因此,GPU性能僅對GPU密集型部分的重建時長產生顯著影響。而對於CPU密集型部分,CPU的性能起到更關鍵作用。
顯卡推薦
在選擇顯卡時,建議根據任務需求和預算選擇適合的型號。以下是我們推薦的顯卡列表,按性能排序:
- L40:在重建任務中,L40憑藉更強的 Core和FP32 能力,提供了最佳的性能表現。
- RTX 4090:作為一款面向消費者的高端顯卡,RTX 4090提供了出色的CUDA Core性能和高效的FP32計算,適合大多數LCC重建任務。
- RTX 4090 D:國內特供版。
- L20:相比於L40,L20仍然保持了較高的CUDA Core和FP32算力,適合性能需求較高但預算相對有限的用戶。
- RTX 3090:雖然性能略低於RTX 4090,但在許多重建任務中依然提供了非常強勁的性能,適合性價比要求較高的用戶。
- A10:適用於預算較為有限的用戶,雖然性能低於上述幾款顯卡,但依然能夠滿足基礎的LCC重建任務需求。
注意:
- 顯存:顯存大小(≥24GB)對LCC重建任務的影響相對較小,除非處理極大規模的場景,否則在推薦的GPU數量區間內,增加更多顯存或顯存超過32GB的顯卡對提升任務效率的作用有限。
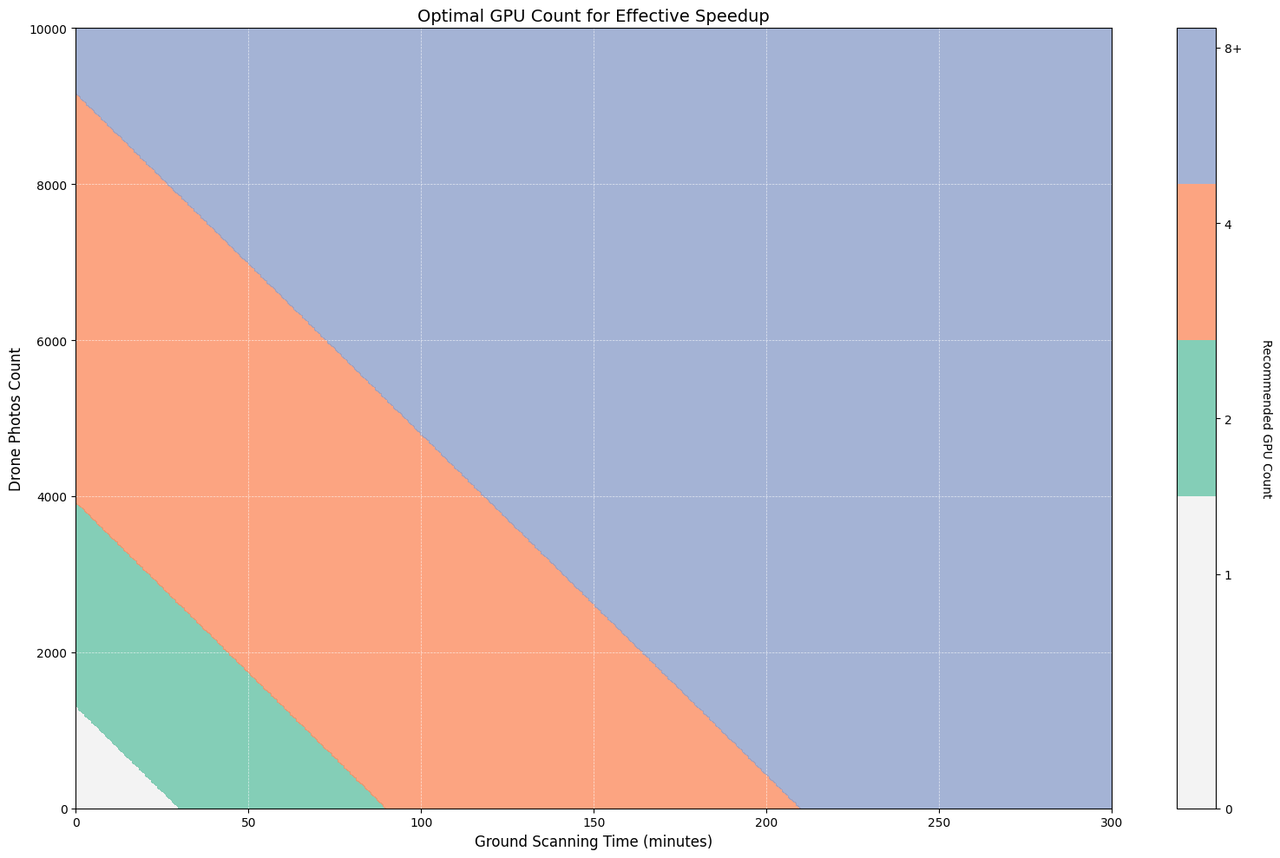
- 多卡配置:當重建較大場景時,多GPU可以產生加速效果。場景大小(掃描時長+無人機圖片數)和最多能使用的GPU卡數的關係如表所示。
下表為GPU性能參照表,其中紅色帶*的型號是實際對比過的型號,有比較準確的相對算力估計;其餘的型號根據相似架構估計得到。
| 型號 | CUDA Core | FP32 TFLOPS | 相對算力 |
|---|---|---|---|
| RTX 5090/ RTX 5090 D | 21760 | 104.8 | 1.27~1.33 |
| RTX 6000 Ada | 18176 | 91.06 | 1.1~1.11 |
| L40 | 18176 | 90.52 | 1.1~1.11 |
| RTX 4090* | 16384* | 82.58* | 1.00* |
| RTX 4090 D* | 14592* | 73.54* | 0.89* |
| H100 PCIe 96G | 16896 | 62.08 | 0.75~1.03 |
| H800 PCIe 80G | 14592 | 51.22 | 0.62~0.89 |
| L20 | 11776 | 59.35 | 0.72~0.72 |
| RTX A6000 | 10752 | 38.71 | 0.64~0.67 |
| RTX 3090* | 10496* | 35.58* | 0.62* |
| A10 | 9216 | 31.24 | 0.54~0.54 |
| L4 | 7424 | 30.29 | 0.37~0.45 |
| A100/A800 | 6912 | 19.49 | 0.34~0.41 |
| RTX 3060* | 3584* | 12.74* | 0.22* |
| RTX 2060 Laptop* | 1920* | 4.608* |
多卡配置
- 當重建較大場景時,多GPU可以產生加速效果。場景大小(地面掃描時長+無人機圖片數)和最多能使用的GPU卡數的關係如表所示。